La regression linéaire permet de résoudre le problème suivant : étant
donnée un ensemble de point \(D = \{(x_i,y_i)
\in \mathbb{R}^2, i = 1 .. n\}\), on cherche une fonction
linéaire \(f \colon x \mapsto \alpha
x\) telle que \(y_i \simeq
f(x_i)\). Comme nous sommes dans le cas simple où nos points sont
dans le plan, on cherche plus exactement le “meilleur” \(\alpha\) tel que \(y_i \simeq \alpha x_i\). On va définir le
meilleur \(\alpha\) comme celui qui
minimise la quantité suivante :
\[\ell_D(\alpha) = (1/n) \sum_{1 \leq i
\leq n} (y_i-\alpha x_i)^2\]
En remarquant que \(\ell_D\) est
quadratique en \(\alpha\) et positive,
on en déduit que le minimum de \(\ell_D\) est atteint là où sa dérivée
s’annule. Un calcul permet de voir que le minimum est atteint en \(\alpha_0 = {\sum_{i\leq n} x_iy_i \over \sum_{i
\leq n} x_i^2}\).
En utilisant la syntaxe numpy, écrivez une fonction
dataset(size: int, a: float, noise: float) qui retourne une
paire de listes (X,Y) tel que
Y[i] = a*X[i]+k[i] où X est une liste de
taille size, X[i] une valeur uniforme entre
\(0\) et \(100\) et k[i] est une valeur
aléatoire, tirée selon la loi normale centrée en 0 et d’écart-type
noise. On pourra utiliser les fonctions random.normal
et random.uniform
de numpy
Correction
def dataset(size: int, a:float, noise: float): X = np.random.uniform(0,100,size) eps = np.random.normal(0,noise,size) Y = a*X+epsreturn (X,Y)
En utilisant matplotlib, affichez sur un graphique les
points \((x_i,y_i)\) générés par votre
fonction précédente. On pourra utiliser la méthode scatter.
Voici un example :
Scatter
Correction
X, Y = dataset(100, 45, 1000)plt.scatter(X,Y)plt.show()
Créer une fonction regression(X,Y) qui prend en
argument deux listes X et Y ayant la même
taille et renvoie la valeur \(\alpha_0\) comme définie dans
l’énoncé.
On souhaite étudier les performances de la fonction
np.sum par rapport à la fonction Python sum en
fonction de la taille du tableau d’entrée. On va utiliser pour cela la
librairie time ainsi :
On observe un facteur 10 entre les deux méthodes, np.sum
étant la plus rapide.
Pour consolider notre intuition, on va réaliser d’autres tests :
générez un tableau pour chaque taille entre 0 et 100000 avec un pas de
1000, calculez le temps de sum et np.sum sur
chaque tableau et affichez les comme des nuages de points avec
matplotlib. Le temps de np.sum doit être en rouge, le temps
de sum en vert. On affichera la légende et le nom des
axes.
Correction
import timeimport numpy as npimport matplotlib.pyplot as pltpytime = []nptime = []size = []for i inrange(0, 100000, 1000): size.append(i) Z = np.random.uniform(1,1000,i) start = time.time() a=sum(Z) end = time.time() pytime.append(1000*(end-start)) start = time.time() a=np.sum(Z) end = time.time() nptime.append(1000*(end-start))plt.xlabel("Taille du tableau")plt.ylabel("Temps de calcul (ms)")plt.scatter(size, pytime, color="green")plt.scatter(size, nptime, color="red")plt.show()
Quel semble être la complexité de ces fonctions ? Utilisez le code
de l’exercice précédent pour trouver prédire les performances de ces
fonctions sur des tableaux de taille arbitraire.
import matplotlib.pyplot as pltimport numpy as npimg = plt.imread("mon_image.jpg") # img est non modifiableimg = img.astype(int) # transforme l'image en tableau modifiable de intplt.imshow(img) # affichage de l'image dans une fenêtreplt.show()
Ce programme utilise matplotlib pour charger une image,
la transformer en un tableau et l’afficher.
Choisissez une image pour travailler dessus et adapter le programme
ci-dessus pour qu’il l’affiche. Les exemples dans cet exerice
utiliseront l’image suivante :
Image exemple
Correction
img = plt.imread("chateau.jpg") # img est non modifiableimg = img.astype(int) # transforme l'image en tableau modifiable de intplt.imshow(img) # affichage de l'image dans une fenêtreplt.show()
En utilisant la méthode shape, donnez les dimensions du
tableau img.
Correction
L’image est un tableau numpy de shape
(w,h,3) où w est la largeur de l’image,
h sa hauteur. Le 3 correspond au trois canaux
de couleurs.
print(img.shape[:2])
Écrire :
Une fonction invert(img) qui retourne une nouvelle
image donc les couleurs sont inversées. La couleur \((r,g,b)\) devient \((255-r, 255-b, 255-b)\).
Couleurs inversées
Correction
def invert(img):return (255-img)
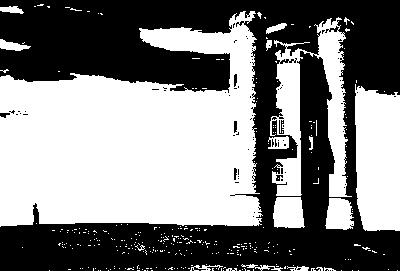
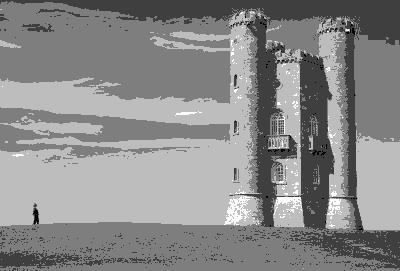
Une fonction level_grey(img,k) qui transforme l’image
en k niveau de gris. Pour cela, on calcule la moyenne \((r+g+b)/3\) et on décide de la tranche de
gris dans laquelle elle se trouve. Par exemple, à trois niveau de gris,
un pixel \((20, 200, 200)\) sera envoyé
sur la couleur \((86, 86, 86)\) parce
que la moyenne des valeurs est \(140\)
et qu’on quantifie l’image en trois niveau de gris: entre \(0\) et \(85\), entre \(86\) et \(171\) et entre \(171\) et \(255\).
Correction
def grey(img,k): m =255/(k-1) avg_grey = np.average(img, axis=2) # valeur moyenne des trois canaux de couleurs greylevel = np.round((avg_grey/m))*m # sélectionne le canalprint(greylevel)return(np.stack((greylevel, greylevel, greylevel), axis=2).astype(int)) # renvoie le gris correspondant
Écrire une fonction histogram(img) qui affiche un
histogramme des couleurs, c’est-à-dire qu’on affiche, pour chaque valeur
\(v\) entre \(0\) et \(255\) et chaque couleur \(c\) dans \(\{R,G,B\}\), un histogramme présentant le
nombre de pixel dont la couleur \(c\) a
valeur \(v\). On pourra utiliser pour
cela :
La fonction numpy.histogram.
Attention à bien spécifier le paramètre bins pour contrôler
les différentes valeurs. On peut utiliser de façon alternative la
fonction numpy.bincount
ou la fonction numpy.unique
avec le paramètre return_counts=True.
def histogram(img): colors = ["red","green","blue"] fig, ax = plt.subplots(1,3) # séparer la figure en trois sous-figures (une pour chaque couleur)for c inrange(3): tc,tb=np.histogram(img[:,:,c], bins=range(257)) ax[c].bar(tb[:-1], tc, color=colors[c],width=1) plt.show()
On va s’intéresser à une technique connue sous le nom de Seam Carving
qui permet de redimmensionner une image en gardant les éléments
importants. Pour appliquer la méthode du Seam Carving, on a besoin de
calculer l’“énergie” de chaque pixel. Intuitivement, un pixel a une
petite énergie s’il est entouré de pixels de valeur similaires, et une
grande énergie s’il diffère beaucoup des autres. Pour un pixel en \((i,j)\), on évalue cela, pour la couleur
\(c \in \{r,g,b\}\), par :
\[(c[i-1,j]-c[i+1,j])^2 +
(c[i,j-1]-c[i,j+1])^2\]
L’énergie d’un pixel est alors la racine carré de la somme de cette
valeur pour chacune des trois couleurs. Le seam carving rétrécit l’image
en enlevant un chemin de moindre énergie.
Écrire une fonction qui calcule un tableau donc les éléments sont
l’énergie de chaque pixel d’une image (vous pouvez l’afficher pour
visualiser). Affichez l’énergie avec matplotlib. On
utilisera pour cela la méthode imshow
qui permet d’afficher une image, comme dans l’exemple. Lorsqu’un tableau
de valeurs numériques est donné en argument, matplotlib le
convertit automatiquement en une information RGB visible. On devrait
avoir :
Niveaux d’énergie
Correction
def energy(img): (x,y,c) = img.shape r = np.zeros((x,y))for i inrange(x):for j inrange(y): r[i][j] =sum((img[(i-1) % x][j]-img[(i+1) % x][j])**2+(img[i][(j-1)%y]-img[i][(j+1)%y])**2)return r
Écrire une fonction qui, étant donné une image d’énergie, trouve le
chemin vertical de moindre énergie. Un chemin démarre par un pixel
quelconque sur la première ligne de l’image et peut descendre en
empruntant le pixel directement dessous ou l’un des pixels à gauche ou à
droite de celui-ci. L’énergie d’un chemin est la somme des énergies des
pixels qui se trouvent dessus. On utilisera une programmation
dynamique.
Chemin de moindre énergie
Indice
Pour cela, on crée un tableau paths de la même taille que
l’image. On veut calculer la valeur suivante : paths[i][j]
doit être l’énergie minimal d’un chemin qui part de la première ligne de
l’image et qui finit à la case \(i\),
\(j\). On le calcule en remarquant que
paths[0][j] = energy[0][j] et que
paths[i][j] = energy[i][j]+min(paths[i-1][j-1], paths[i-1][j], paths[i-1][j+1]).
Correction
On calcule dynamiquement le tableau paths comme indiqué
dans l’indice. On commence par l’initialiser avec les valeurs d’énergie
puis on descend dans le tableau et on mets à jour chaque ligne en
appliquant la formule obtenue au-dessus.
Une fois cela fait, on reconstruit le chemin. Pour cela, on part de
la dernière ligne de paths et on trouve l’index du minimum
(np.argmin). On sait que le chemin de moindre énergie se
termine en ce point. On remonte ensuite dans paths en
sélectionnant l’index au-dessus qui a la moindre énergie.
def path_vec(energy): (h,w) = energy.shape paths = energy # Calcul des chemins de moins énergies en tout pointfor i inrange(h): paths[i] += np.min((paths[i-1], np.roll(paths[i-1], 1), np.roll(paths[i-1], -1)), axis =0) paths[i][0] = energy[i][0] +min(paths[i-1][0], paths[i-1][1]) paths[i][-1] = energy[i][-1] +min(paths[i-1][-1], paths[i-1][-2])# Reconstruction du chemin path = np.zeros(h, dtype=int) path[-1] = np.argmin(paths[-1])for i inrange(1,h): j = path[h-i]if j ==0: path[h-i-1] = j + np.argmin((paths[h-i-1][0], paths[h-i-1][1]))elif j == w-1: path[h-i-1] = j + np.argmin((paths[h-i-1][-2], paths[h-i-1][-1])) -1else: path[h-i-1] = j + np.argmin((paths[h-i-1][j-1], paths[h-i-1][j], paths[h-i-1][j+1])) -1return path
Conclure avec un programme qui peut redimensionner une image.
Correction
On écrit une fonction qui enlève un chemin de l’image et on boucle en
enlevant le chemin de moindre énergie.
def remove_path(img, p): h,w,b = img.shape r = np.zeros((h,w-1,b))for i inrange(h): r[i] = np.delete(img[i], p[i], 0)return rdef reduce_img(img, w): # On enlève w chemins dans img r = imgfor i inrange(w): e=energy_vec(r) p=path_vec(e) r = remove_path(r, p)return r
Réfléchir à un moyen d’écrire un code vectoriel avec
numpy pour accélérer le calcul d’énergie.
Correction
En écrivant img[:-2] - img[2:], on trouve les
différences entre les pixels à distance 2 verticalement. On peut donc
écrire quelque chose comme cela :


