\(
\newcommand{\R}{\mathbb{R}}
\newcommand{\Rp}{\mathbb{R_+}}
\newcommand{\Z}{\mathbb{Z}}
\newcommand{\Rn}{\mathbb{R}^n}
\newcommand{\N}{\mathbb{N}}
\renewcommand{\to}{\rightarrow}
\newcommand{\from}{\colon}
\renewcommand{\Vec}{\mathsf{vec}}
\newcommand{\Ker}{\mathrm{Ker}}
\renewcommand{\Im}{\mathrm{Im}}
\newcommand{\rang}{\mathrm{rang}}
\newcommand{\O}{\mathcal{O}}
\newcommand{\C}{\mathcal{C}}
\newcommand{\U}{\mathcal{U}}
\newcommand{\x}{\mathbf{x}}
\newcommand{\X}{\mathbf{X}}
\newcommand{\z}{\mathbf{z}}
\newcommand{\w}{\mathbf{w}}
\newcommand{\W}{\mathbf{W}}
\newcommand{\a}{\mathbf{a}}
\newcommand{\b}{\mathbf{b}}
\newcommand{\B}{\mathbf{B}}
\newcommand{\dpartial}[2]{{\partial #1 \over \partial #2}}
\newcommand{\d}{\mathbf{d}}
\)
Variation sur les Réseaux de Neurones
Programmation pour l’IA
Florent Capelli
Université d’Artois, CRIL
Réseaux de Neurones Convolutifs
Convolution 1D
- Opération sur les listes
- Origine dans le traitement du signal : agréger les informations
d’un voisinage dans un point.
- On fait “glisser” sur une liste \(L\) \(K\)
une petite liste appelée le kernel.
\[ (L*K)[i] = \sum_{a=0}^{k-1} L[i+a]
\times K[a] \]
- Si \(L\) est de longueur \(l\) et \(K\) de longueur \(k\), alors la liste produite est de
longueur \(l-k+1\).
Exemple pour un kernel de taille \(3\) :
| L |
1 |
4 |
2 |
-1 |
3 |
8 |
0 |
7 |
|---|
| K |
|---|
| K | 1 | -1 | 1 | | | | | | |
|---|
| K | | 1 | -1 | 1 | | | | | |
|---|
| K | | | 1 | -1 | 1 | | | | |
|---|
| K | | | | 1 | -1 | 1 | | | |
|---|
| K | | | | | 1 | -1 | 1 | | |
|---|
| K | | | | | | 1 | -1 | 1 | |
|---|
Convolution 2D
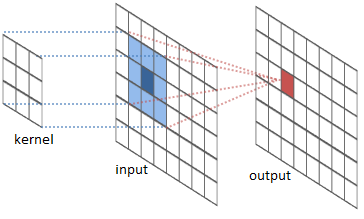
- Pareil pour les matrices
- Mathématiquement, si \(M\) est une
matrice \(n_1 \times n_2\) et \(K\) une matrice \(k_1 \times k_2\),
\[ (M * K)[i,j] = \sum_{a=0}^{k_1-1}
\sum_{b=0}^{k_2-1} M[i+a, j+b] \times K[a,b]\]
où \(0 \leq i < n_1-(k_1-1)\) et
\(0 \leq j < n_2 - (k_2-1)\).
\(M*K\) est une matrice \((n_1-k_1+1) \times (n_2 - k_2+1)\).
![]()
Image et convolution 2D
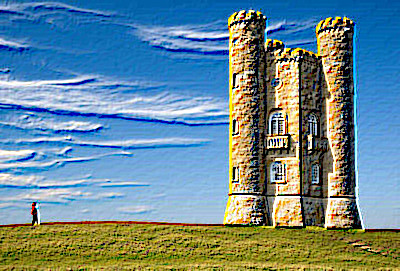
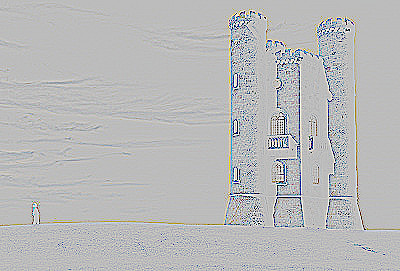
Étudié depuis longtemps en traitement de l’image.
Convolutions intéressantes connues :
Ici, la convolution est appliquée sur chaque couleur \((R, G, B)\) indépendamment (on parle de
canaux/channels).
Exemple
| M |
|---|
| 1 |
0 |
1 |
2 |
| 2 |
3 |
1 |
2 |
| 0 |
1 |
2 |
0 |
| 3 |
2 |
2 |
1 |
| M * K |
|---|
| 2 |
-3 |
0 |
| 0 |
3 |
-3 |
| -2 |
-1 |
1 |
Padding
- Si \(M\) est une matrice \(n \times n\) et \(K\) une matrice \(k \times k\), alors \(M * K\) est de dimension \(n-k+1 \times n-k+1\).
- Parfois utile de garder la même dimension.
- Padding: on transforme \(M\) en \(M'\) de taille \(n+k-1 \times n+k-1\) en ajoutant des lignes
des des colonnes.
- Ainsi : \(M' * K\) est une
matrice \(n \times n\).
Padding le plus courant : ajouter des lignes/colonnes nulles (mais
aussi : copier les dernières colonnes, copier les première etc.)
Exemple avec padding
- Cas d’une convolution avec un kernel \(3
\times 3\)
- Ajouter deux colonnes et deux lignes de \(0\).
- \(M*K\) a la même dimension que
\(M\).
|
1
|
0
|
1
|
2
|
|
2
|
3
|
1
|
2
|
|
0
|
1
|
2
|
0
|
|
3
|
2
|
2
|
1
|
|
0
|
0
|
0
|
0
|
0
|
0
|
|
0
|
1
|
0
|
1
|
2
|
0
|
|
0
|
2
|
3
|
1
|
2
|
0
|
|
0
|
0
|
1
|
2
|
0
|
0
|
|
0
|
3
|
2
|
2
|
1
|
0
|
|
0
|
0
|
0
|
0
|
0
|
0
|
| M' |
|---|
| 0 |
0 |
0 |
0 |
0 |
0 |
| 0 |
1 |
0 |
1 |
2 |
0 |
| 0 |
2 |
3 |
1 |
2 |
0 |
| 0 |
0 |
1 |
2 |
0 |
0 |
| 0 |
3 |
2 |
2 |
1 |
0 |
| 0 |
0 |
0 |
0 |
0 |
0 |
| M' * K |
|---|
| -2 |
5 |
-1 |
-5 |
| -4 |
-8 |
4 |
-5 |
| 6 |
3 |
-4 |
5 |
| -10 |
-2 |
-3 |
-2 |
Couche de Convolution
- Couche appliquant une ou plusieurs convolutions
- Paramètres : les kernels de chaque convolution.
- Intuition: on apprend les kernels intéressants (et
non pas un kernel “connu”)
- Donne une couche qui n’est pas complètement
interconnectée.
- Moins de paramètres
- Respecte les informations “spatiales” (dans l’image) ou “temporel”
(dans une séquence).
En Pytorch
Trois couches principalement : nn.Conv1d (séquences),
nn.Conv2d (image), nn.Conv3d (dans
l’espace)
nn.Conv2d(in_channel=3, out_channel=5, kernel_size=2)
- Kernels de taille
kernel_size (ici \(2 \times 2\))
- Applique une convolution différente sur chaque canal d’entrée
in_channel (couleur RGB, stéréo etc.) et les
additionne.
- On additionne aussi un biais.
- Cela est fait
out_channel fois.
- On peut spécifier
padding = 1 par exemple qui rajoutera
deux lignes et deux colonnes de \(0\)
(début et fin).
Analyse de paramètres
nn.Conv2d(in_channel=3, out_channel=5, kernel_size=2)
- Input \((3, N, M)\) (\(3\) channels, \(N,M\) taille des matrices)
- On sort un tenseur de forme \((5, N-2,
M-2)\).
- Analyse des paramètres :
- \(3\) kernels pour chacun des \(5\) canaux de sorties : 15 matrices \(2 \times 2\) donc 60 paramètres.
- \(5\) biais.
- \(65\) paramètres en tout.
Comparons avec une couche linéaire complètement connectée :
- Entrée \(3NM\)
- Sortie \(5(N-2)(M-2)\)
- Donc on aurait \(15N(N-2)M(M-2)\)
paramètres (>30k paramètres pour \(N=M=8\)).
Pooling
- Autre aggrégation locale de donnée dans une séquence, matrice
etc.
- Applique une fonction \(f : Mat(k_1,k_2)
\rightarrow \R\)
- Décompose la matrice en blocs de taille \(k_1 \times k_2\) disjoints et applique
\(f\) indépendamment.
Exemple avec \(k_1=k_2=2\) et \(f = \max\) :
|
1
|
0
|
1
|
2
|
|
2
|
3
|
1
|
2
|
|
0
|
1
|
2
|
0
|
|
3
|
2
|
2
|
1
|
|
\(f(B_1)\)
|
\(f(B_2)\)
|
|
\(f(B_3)\)
|
\(f(B_4)\)
|
En Pytorch
Beaucoup de couches permettant des opérations de “pooling” :
kernel_size permet de spécifier la taille de bloc- Max:
nn.MaxPool1d, nn.MaxPool2d,
nn.MaxPool3d
- Moyenne:
nn.AvgPool1d, nn.AvgPool2d,
nn.AvgPool3d etc.
Pas de paramètres entraînables.
Résumé
Pour le traitement d’image (et plus généralement de signaux) :
- L’entrée n’est plus nécessairement un vecteur de features
- Couches de convolution et de pooling :
- respecte la connectivité locale
- moins de paramètres
- Architecture particulièrement adaptée à la reconnaissance
d’images.
Limites
On continue à traiter des signaux bornés, donc pas
applicable au texte, musique etc.
Besoin d’autres architectures :
- Recursive Neural Networks (RNN) : une partie de la
sortie est réutilisée dans l’entrée.
- Transformers : mécanismes d’attention.